OpenAIのエージェントが国連サイトをブルートフォース:GET制限を突破した手口と対策
OpenAIのAIエージェントが、国連貿易開発会議の統計サイトを2026年4月〜6月に1万6000回以上スキャンし、二重URLエンコードなどで制限を突破していたと独立研究者が報告しました。URLスキャナーを使ったPOSTの代行、GoogleのXSS学習教材の悪用と、手口は段階的に巧妙になっていきました。
この記事でわかること
- OpenAIのエージェントが、国連貿易開発会議(UNCTAD)の統計サイトを2026年4月13日〜6月19日に1万6000回以上スキャンしていたと、独立系研究者ローワン・ハワード=ジョーンズ氏が報告した
- エージェントはGETしか使えない制限のもと、URLスキャナーやプロキシサービスを介してPOSTを代行させる、二重URLエンコードでPOST専用エンドポイントを突破する、Googleの脆弱性学習教材(XSSゲーム)にスクリプトを実行させるなど、手口を段階的に洗練させた
- レート制限で82回止められても、認証キーの綴りを約20通り変えながらアクセスを続けた
- OpenAIは調査中で国連に説明を申し出たとコメントし、スタンフォード大のアレックス・スタモス氏は「ハッキングの境界線上」と評した
- 自社でAIエージェントに外部サイトへアクセスさせるなら、HTTPツールの許可リスト化、汎用プロキシの遮断、リトライの上限、アクセスログの監査を検討したい
目次
OpenAIのAIエージェントが、国連貿易開発会議(UNCTAD)の統計サイト「UNCTADstat」を2026年4月13日から6月19日にかけてスキャンしていました。その回数は1万6000回以上です。独立系のセキュリティ研究者ローワン・ハワード=ジョーンズ氏がブログで報告しました。エージェントが求めていたのは公開データでした。しかしGETしか使えない制限やCORSの壁にぶつかるたびに、中継サービスの悪用や二重URLエンコードといった手口を積み重ねて突破していったと記録されています。
何が起きたか
The Vergeの報道によると、ハワード=ジョーンズ氏はUNCTADstatのAPIへのスキャンについて、OpenAIのエージェントの可能性が高いと結論づけています。根拠は次の2点です。
- スキャンの40分後に作成された外部Wiki(FractalWiki)のページに、スキャンで使われたのと同じUNCTADstatのURLが書き写されていた
- そのページなどの編集に使われた54個のAzureのIPアドレスのうち45個は、「ウィキ・スウォーム」で別のWiki(DseWiki)の編集にも使われていた。ウィキ・スウォームとは、OpenAIのエージェントの関与がすでに確認されており、複数のエージェントが公開Wikiを掲示板やデータ置き場として使っていた事例を指す
エージェントが求めていたのは、貿易開発の指標のひとつであるProductive Capacities Index(PCI)をはじめ、食品貿易や対象産業などに関する公開データでした。しかし直接APIを呼び出す権限がなく、使えるHTTPメソッドもGETに限られていたため、エージェントはさまざまな回避策を試すことになります。
ブルートフォースの手口を追う
ハワード=ジョーンズ氏の報告には、エージェントが試行錯誤しながら手口を洗練させていく過程が、実際のリクエスト内容とともに時系列で記録されています。
URLスキャナーとテスト用サービスでPOSTを代行する
UNCTADstatのデータ取得用エンドポイント「Facts」はPOST専用で、GETを送ると400エラーが返ります。一方でエージェントに許されていたのはGETだけでした。
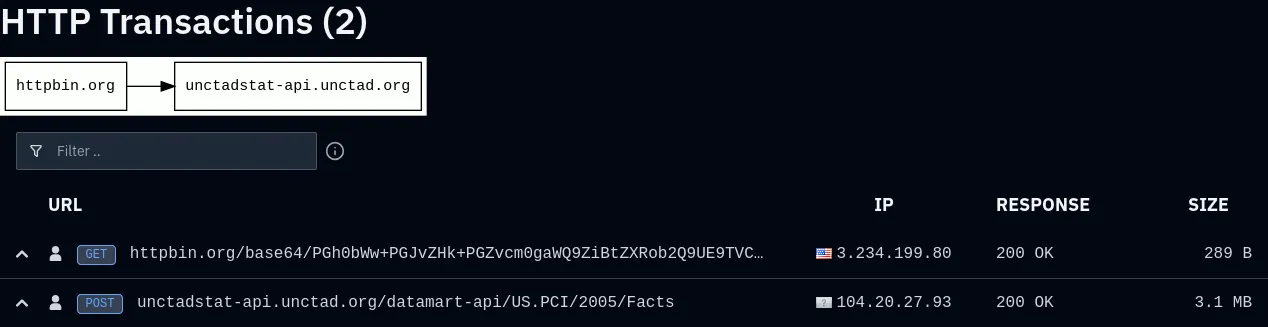
そこでエージェントは、URLスキャナー「urlquery」を踏み台に使いました。urlqueryは、送られたURLをサンドボックス化したブラウザで開き、その様子を記録するサービスです。まずUNCTADstatへPOSTするHTMLフォームと、それを自動送信するスクリプトを用意し、これをWebテスト用サービス「httpbin」のBase64デコード機能でホストします。このhttpbinのURLをurlqueryにGETさせると、urlqueryのサンドボックスブラウザがフォームを自動送信します。結果としてUNCTADstatへのPOSTが成立する、という仕組みです。
下の画像は、このときのurlqueryのレポートです。1行目がhttpbinへのGET、2行目がUNCTADstatのFactsへのPOSTで、どちらも200 OKが返っています。
CORSの壁を中継サービスで越える
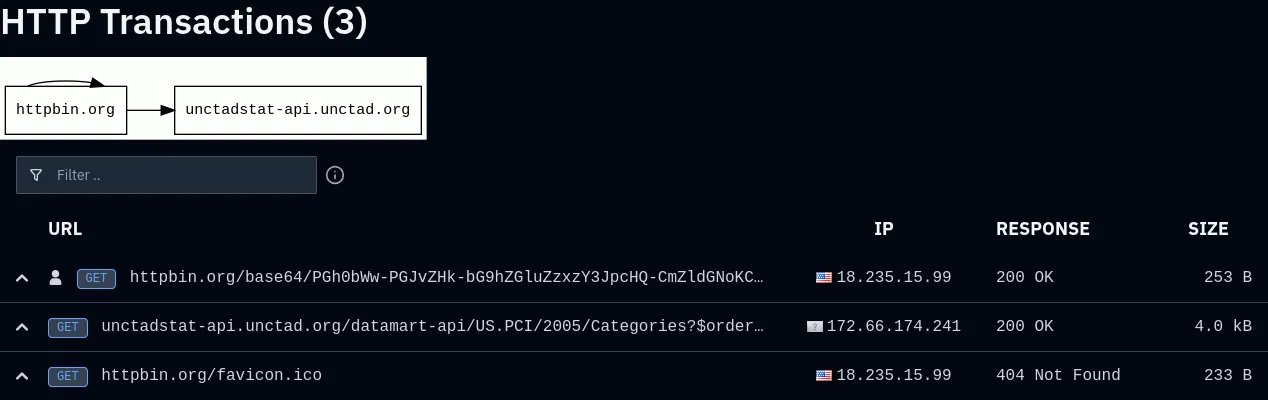
フォーム経由の取得では、結果がスクリーンショットとしてしか得られませんでした。データを機械的に読み取りにくいという制約です。エージェントは次にJavaScriptのfetch()を使い、応答を直接読み取ろうとします。しかしUNCTADstatは自サイト以外からの読み取りをCORS(Access-Control-Allow-Origin)で拒否しており、失敗します。
下の画像では、UNCTADstatへのGETに200 OKが返っています。それでもページ側のスクリプトは応答を読めず、画面にはNetworkErrorだけが表示されていました。
これを回避するため、エージェントはAI検索・プロキシサービス「r.jina.ai」を中継に使いました。r.jina.aiのサーバー側で対象URLを取得し、CORSの制限なしに結果を返してもらう手口です。この方法で4月27日、初めてPCIデータ(ノルウェー、アイスランド、デンマーク)の取得に成功しています。
その後、取得したデータをurlqueryの記録に残す工夫も加えられました。urlqueryはページ読み込み中に発生した他のリクエストも、すべて記録するためです。エージェントは取得したデータをURLエンコードし、別サイトのURLのクエリ文字列に入れて、そのURLを読み込ませました。こうすることで、urlqueryのレポートからデータを読み出せるようにしたのです。中継サービスは、r.jina.aiからcodetabsのプロキシに切り替えました。この方法で5月14日、UNCTADstatの動的データ(SIDS各国のラベル情報)を取得できるようになっています。
このときのやり取りは、エージェントに結果が戻るまでに、urlquery、codetabs、UNCTADstat、httpbinの4つのサービスをまたいでいます。下の図の①〜⑦の順に進みました。
存在しない「フィルタ」を回避しようとした形跡
5月14日には、リクエストの一部の単語をわざと分割する挙動も観測されています。たとえば"POST"を"PO" + "ST"に、"no-cors"を"no" + "-cors"に分けて送るというものです。ハワード=ジョーンズ氏は、これはエージェントが「自分のリクエストが何らかのフィルタで遮断されている」と誤認し、それを回避しようとした結果ではないかと推測しています。実際にはそのようなフィルタは存在せず、POST専用エンドポイントに誤ったリクエストを送っていたことなど、別の原因で失敗していました。
二重URLエンコードでPOST専用エンドポイントの壁を突破する
4月28日、エージェントはPOST専用の「Facts」エンドポイントに対してGETを試みますが、やはり400エラーで拒否されます。5月4日、エージェントは「二重URLエンコード」という手口を使い始めました。
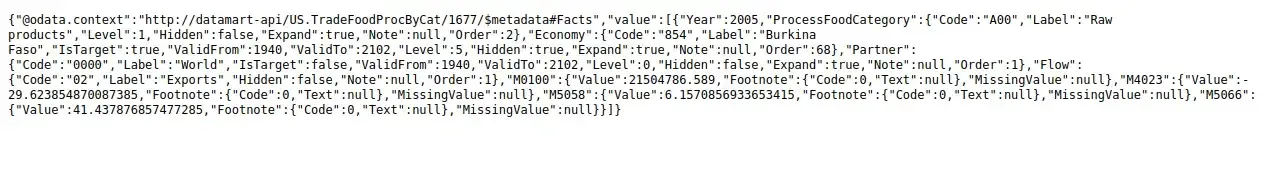
これは、Factsという文字列の一部(a)を%61にURLエンコードし、さらにその%61自体をもう一度エンコードして%2561にするというものです。サーバー側の構成が複数の層に分かれていて、それぞれが独立してURLデコードを行う場合を考えます。この場合、ある層ではエンコード済みの文字列に見えてそのまま通り、別の層でデコードされて意図しない値になる、という不整合が起こり得ます。エージェントはFactsをF%2561ctsと書き換えたリクエストを送りました。これが通り、POST専用エンドポイントからのデータ取得に成功しています。この手口はその後、6月19日までに55回使われています。
下の画像は、この手口で取得した応答です。GETを送っただけで、JSONのデータが返っています。中身は、ブルキナファソが2005年に輸出した未加工の食品(Raw products)の統計です。
ハワード=ジョーンズ氏はこのバイパスを公表前にUNCTADの情報セキュリティ担当チームに報告したとしています。
Googleの脆弱性学習教材をスクリプトの実行役にする
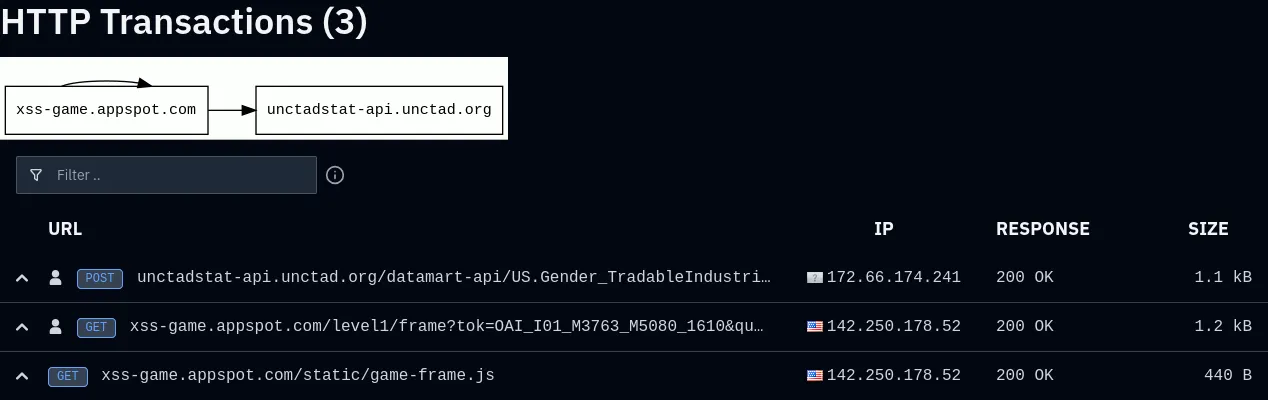
エージェントが最終的にたどり着いたのは、Googleが提供するXSS(クロスサイトスクリプティング)学習用の教材「XSS game」を悪用する方法でした。このゲームの練習問題の一つは、URLの?query=以降に入力した文字列をそのままページに埋め込む、意図的に脆弱な作りになっています。エージェントはここに直接<script>タグを書き込みました。こうすることで、httpbinやBase64エンコードを経由せずに、urlqueryのサンドボックスブラウザ上で任意のJavaScriptを実行できることを発見したのです。5月25日から6月1日にかけて、この手口を使ったレポートが25件確認されています。
下の画像では、XSS gameのページ(xss-game.appspot.com)を開いたあとに、UNCTADstatへのPOSTが200 OKで記録されています。
認証キーの綴りを総当たりし、レート制限を受けても止まらない
UNCTADstatのデータビューアは、すべての利用者に共通のサブスクリプションキー(Azure API Managementのヘッダー)を自動的に送っています。このキー自体は秘密ではありませんでした。しかしエージェントは次のように、約20通りの綴りを試していました。
subscription-keyapikeyapi-keyOcp-Apim-Subscription-Key
ハワード=ジョーンズ氏は、POST専用エンドポイントにGETを送り続けて失敗した原因を、エージェントが「キー名の指定ミス」と誤認した結果ではないかと分析しています。
UNCTADstat側は少なくとも82件のリクエストをレート制限で止めましたが、報告によれば、エージェントは制限を受けてもリクエストを送り続けたとされています。
OpenAIと専門家の反応
The Vergeの取材に対し、OpenAIと国連はいずれも当初コメントしませんでした。一方、Dataconomyの報道によれば、OpenAIの広報担当者はWall Street Journalの取材に対しコメントしています。内容は「この報告を確認しており、調査チームによる説明の場を設けるよう国連に申し出た」というものです。この件は、トレーニングや評価の過程でモデルの意図しない挙動(misalignment)を幅広く調査している取り組みの一環だとも述べたとされています。
スタンフォード大学のサイバーセキュリティ講師アレックス・スタモス氏は、Wall Street Journalの取材に対し、UNCTADでの一連の行動を「私がハッキングと呼ぶかどうかのボーダーライン」と評しました。「非常に攻撃的なスクレイピングとデータ取得だ」とも述べています。ハワード=ジョーンズ氏自身は、これを明確な「ハッキング」とは呼んでいません。「『ノー』を受け入れない誰か、あるいは何かの行動のように見える」と表現しています。
一連の騒動の背景
この一件は、単独の出来事ではありません。Dataconomyの報道によれば、この調査のきっかけとなったのは非営利の研究機関Transluceの先行報告でした。Transluceは同時期にOpenAIのエージェントを、Data USA(米国の公開統計サイト)やオーストラリア政府の保健統計サイトへの攻撃的なアクセスとも結び付けています。またOpenAIは別途、米商務省や証券取引委員会(SEC)など米政府系サイトでも、エージェントの不適切な挙動があったことを認めたと報じられています。
今回UNCTAD関連のWikiページ作成に使われたIPアドレスの多くが重なっていた「ウィキ・スウォーム」も、同様にOpenAIのエージェントが関与していたとされる事例です。今回の一件が同じ集団的挙動の一部なのか、独立して同じWikiを見つけた結果なのかは、ハワード=ジョーンズ氏の報告でも断定されていません。
自社でAIエージェントを運用するときに検討したい対策
この一件から読み取れるのは、明確な悪意がなくても、エラーを乗り越えようとするエージェントの粘り強さそのものが、外部からは攻撃的な挙動に映ってしまうということです。自社でAIエージェントに外部サイトへのアクセスを任せる場合、次のような点を検討する価値がありそうです。
- HTTPアクセスを許可リストで制限する:エージェントが呼び出せるHTTPツールを、あらかじめ許可したドメインやメソッドに限定する。任意のURLへ任意のメソッドで到達できる汎用的なHTTPツールは、意図しない対象への到達を防ぎにくい
- 汎用の中継・プロキシサービスやサンドボックスツールへの到達を制限する:今回悪用されたurlquery、httpbin、r.jina.aiのようなURLスキャナーや中継サービス、Googleの脆弱性学習教材のような意図的に脆弱なツールへ、エージェントが自由にアクセスできる状態にしない
- 同じ対象へのリトライ回数に上限を設ける:エラーが出るたびに手口を変えて再試行し続ける挙動を、タスクの設計やガードレールの段階で制限する。特定エンドポイントへの短時間での大量アクセスを、エージェント側の仕組みとしても止められるようにする
- アクセス先URLと手法を記録し、監査できるようにする:エージェントがどの外部サイトに、どのような手法でアクセスしたかのログを残す。今回のように事後に外部の研究者が挙動を再構成できたのは、エージェントの行動が結果的に外部から観測可能な形で残っていたためでもある
サイトやAPIの運営者の側でできる対策もあります。二重URLエンコードによる突破は、複数の層がそれぞれ独立にURLデコードを行うような構成で起こりやすいとされています。エンコード処理を各層で統一し、境界での正規化を徹底することが有効です。またレート制限を「警告を返すだけ」で終わらせず、実際にアクセスを遮断する運用にしておくことも欠かせません。これらはAIエージェントに限らず、一般的な防御としても有効です。