Lightpanda 1.0は、ヘッドレスChromeの代わりになるか
この記事で分かること
- Lightpandaは、Chromiumの派生ではなくZigで一から書かれたヘッドレスブラウザ。JavaScriptはChromeと同じV8で動かすが、レイアウトと描画の処理を持たない。10月2日に1.0になり、ベータを抜けた
- 公式の計測では933ページを巡回する処理で、25並列のときに4.81秒・123MB。Chromeは46.70秒・2.0GBだった。Chromeは1つのブラウザでタブを増やし、Lightpandaはプロセスを増やした比較で、計測は開発元によるもの
- Puppeteer、Playwright、chromedpはCDPで、SeleniumはWebDriver BiDiで接続でき、ページからテキストや値を取り出す処理なら置き換えを試せる。ただし、スクリーンショットは仮の画像を返し、要素の位置は実際のレイアウトではない。PlaywrightのCDP接続は、Playwright自身が忠実度の低い接続だとしている
- ライセンスはAGPL-3.0。利用状況の送信は既定で有効で、環境変数LIGHTPANDA_DISABLE_TELEMETRYで止められる。User-Agentに「mozilla」を含められないため、Chromeを装った巡回には使えない
スクレイピングやE2Eテスト、AIエージェントにWebを読ませる処理の多くは、PuppeteerやPlaywrightからヘッドレスのChromeを動かしています。画面に何も映さないのに、Chromeは描画のための計算を続けるので、数百の単位で並べるとメモリとCPUを食います。Lightpandaは、この描画の部分を最初から持たないブラウザです。
10月2日に1.0が公開され、ベータの表示が外れました。今動いているChromeの処理を、どこまでLightpandaに置き換えられるのか。速さの数字が出た条件、Chromeと違う動き、ライセンスと送信される情報を、公式のドキュメントとリポジトリで確かめました。
描画をしないブラウザ
Lightpandaは、ChromiumやWebKitを元にせず、Zigという言語で一から書かれています。とはいえ、全てを自作しているわけではありません。READMEの「Status」によると、JavaScriptの実行にはChromeと同じV8を使っています。HTMLの解析はServoのhtml5ever、通信はlibcurlです。
Chromeとの違いは、スタイルの計算、レイアウト、ペイントのような、ページを画素にする処理を持たないことです。アーキテクチャの説明は、機械が使うのはDOMで、画面の絵ではないという考え方で作ったとしています。ページを取得し、スクリプトを動かし、メモリ上のDOMを読み書きするところまでがブラウザの仕事です。
開発元は以前の会社でヘッドレスChromeを並べて1日2,000万ページ超のデータを集めていて、その費用と運用の手間から作り始めたと書いています。1.0の発表によると、ベータを公開した2024年11月の時点では、Web APIが足りずに読み込めないサイトが多かったそうです。
使い方は5つあり、どれもlightpanda <コマンド>の形で起動します。
| コマンド | 向いている処理 |
|---|---|
fetch | 1回だけ取得し、JavaScriptを動かしたあとのHTMLやMarkdownを標準出力に出す |
serve | CDPサーバーになり、Puppeteer、Playwright、chromedpから接続する。--protocol webdriverでWebDriver BiDiにもなる |
mcp | MCPサーバーになり、AIエージェントのツールとして使う |
agent | 自然文で操作を頼み、操作を記録する |
run | 記録したスクリプトを、LLMを使わずに再生する |
fetchは--dump markdownで、JavaScriptを動かしたあとのページをMarkdownにして出せます。Markdownとアクセシビリティツリーのガイドによると、semantic_treeを指定すれば、アクセシビリティツリーをJSONでも出せます。LLMに読ませる前に、HTMLを別のツールで変換する手間がありません。
9倍速い、16倍軽いという数字の条件
公式のベンチマークのページは、ヘッドレスChromeと比べた計測を3つ載せています。1つ目と2つ目の相手はChrome 143で、いずれも開発元が計測したものです。
1つ目はデモの商品カタログの933ページを、リンクをたどって巡回する処理です。AWSのm5.xlargeで、Goのchromedpから両方を同じコードで動かしています。
| 並列数 | Lightpanda | Chrome |
|---|---|---|
| 1 | 51.68秒・27.2MB | 82.83秒・1.3GB |
| 5 | 11.70秒・43.9MB | 45.66秒・1.6GB |
| 25 | 4.81秒・123.0MB | 46.70秒・2.0GB |
| 100 | 5.23秒・410.2MB | 69.37秒・4.2GB |
READMEの冒頭のグラフも、この巡回の結果を載せています。
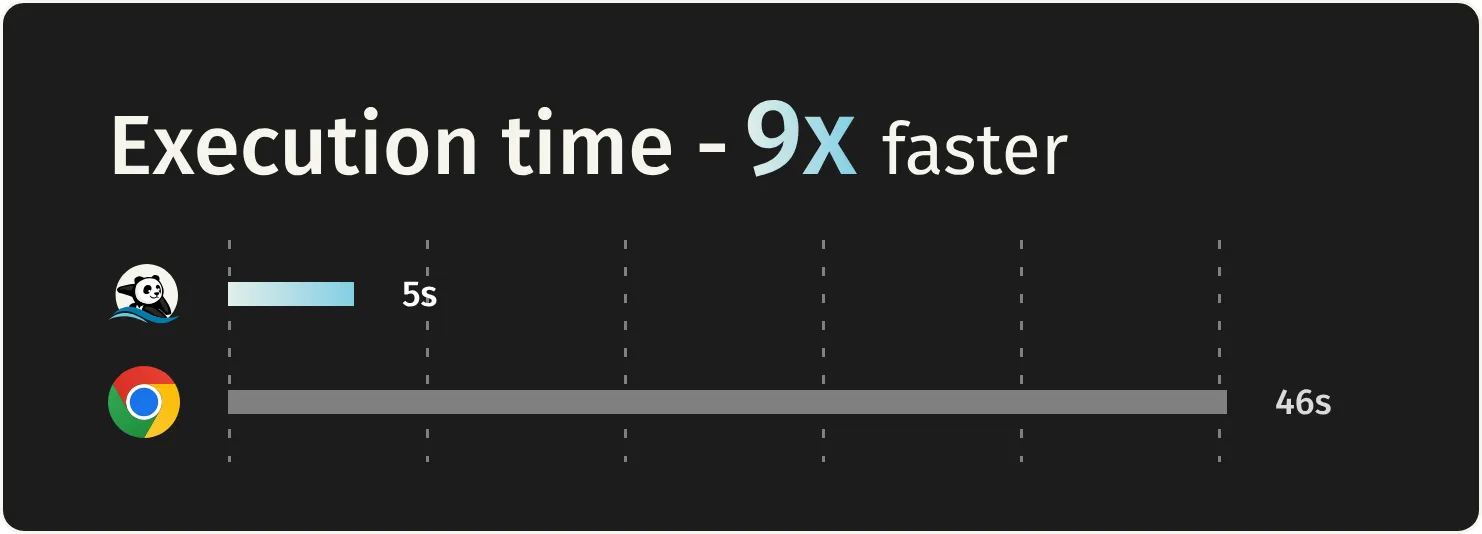
「9倍速く、16倍軽い」は、25並列の行から出た数字です。読むときに気を付けたいのは並列の数え方です。Chromeは1つのブラウザでタブを増やし、Lightpandaはプロセスを増やしています。Lightpandaは1つのプロセスで複数のタブを開けないためで、開発元はそれぞれの本番での使われ方に合わせたと説明しています。Chromeが5並列から先で速くならない理由は、タブどうしが同じプロセスの資源を取り合うからだそうです。
2つ目はXHRで商品情報とレビューを読み込むページを、Puppeteerから100回読み込んで値を取り出す処理です。1回の平均はLightpandaが16ms、Chromeが185msで、メモリの最大はLightpandaが21.2MB、Chromeが402.1MBでした。ページはローカルのWebサーバーから配っていて、ネットワークの遅れは数字に入っていません。
3つ目はAIエージェントの正答率で、ここは描画をしないことの影響が見えます。Vercelのagent-browserにClaude Sonnet 4.6を組み合わせ、エンジンだけをChromiumからLightpandaに替えた場合です。GAIAのレベル1では、正答率が84.9%から81.1%に下がりました。開発元によると、描画したページなら見える内容を、Lightpandaのテキストだけの出力が取りこぼしたページがありました。AssistantBenchでは、どちらのエンジンでも57.6%で同じでした。
1.0の発表には本番で使っている会社の声も載っています。AIエージェント向けの検索を作るKeenableは、Chromiumより4倍速く、費用の効率は6倍だとしています。プリレンダリングをChromeから移したDeveloperHub.ioは、ページを返す速さが4倍になり、サーバーの負荷を示すロードアベレージが10分の1になったそうです。どれも開発元のブログに載った利用者の数字で、Keenableの数字には計測の条件が書かれていません。
Chromeと同じには動かないところ
PuppeteerやPlaywrightからは、接続先を変えるだけで使えます。Playwrightのガイドでは、lightpanda serveで起動したサーバーにchromium.connectOverCDP('ws://127.0.0.1:9222')でつなぎ、残りのコードはそのまま使えます。ただし、次の4つはChromeと同じには動きません。
画面の画素に頼る処理は動きません。 アーキテクチャの説明によると、CDPのPage.captureScreenshotが返すのは、実際に描画した画像ではなく仮の画像です。要素の大きさはCSSとHTMLの属性からの近似で、位置はDOMの深さと兄弟の順から作った値です。画面の見た目を比べるテストや、座標を見てクリックする処理は、Chromeに残すことになります。READMEにある--dump pngと--dump pdfの出力も、テキストだけをレンダリングしたものです。
Web標準の対応は、Chromeの8割ほどです。 1.0の時点で、LightpandaはWeb Platform Testsの小テストのうち、合格は1,739,845件です。Chromeは2,184,491件で、開発元は差の半分以上がCSS、編集、SVGの検査だとしています。2026年4月には文字コードの検査が通るようになり、件数が数日で跳ね上がったとも書いています。この検査は約115万件の小テストを含み、大半は自動で作った文字の対応表です。件数の比を、動くサイトの割合と読まないほうがよさそうです。
Playwrightとの接続は、CDP経由になります。 PlaywrightのconnectOverCDPの説明によると、CDPでの接続は、Playwright独自の接続より忠実度がかなり低いものです。高度な機能を使うなら、独自の接続を勧めています。Playwrightのテストを丸ごと移すより、ページを取得して値を読む処理から試すのが安全そうです。
1つのプロセスで開けるタブは1つです。 並列にするときは、ポートを変えてプロセスを複数起動する形です。Chromeの1プロセスに多数のタブを開く構成から移すなら、起動と監視の作り方も変わります。
使う前に確かめたいこと
ライセンスはAGPL-3.0です。このライセンスでは改変したプログラムをネットワーク越しに利用者へ使わせる場合にも、その利用者にソースを提供する義務がかかります。社内の巡回に使うだけか、改変して外部に提供するかで扱いが変わるので、組み込む前に社内の基準と照らし合わせる必要がありそうです。プルリクエストで貢献する人には、CLA(貢献者のライセンス同意)への署名も求められます。
利用状況の送信は既定で有効です。ローカルとクラウドの比較によると、送るのは、TLSを使ったかどうか、開いたのがページかiframeか、エージェントで使ったLLMの提供元とモデル名です。開いたURLやページの中身は含まないとしています。送信は環境変数LIGHTPANDA_DISABLE_TELEMETRYを設定すると止まります。
Chromeを装うことはできません。 利用の手引きによると、--user-agentは「mozilla」を含む値を受け付けません。さらに、Sec-Ch-Ua: "Lightpanda";v="1"のヘッダーを常に送ります。巡回する側が名前を名乗る前提で作られているようです。--obey-robotsでrobots.txtに従わせる設定や、Web Bot Authで自分のリクエストに署名する設定もあります。一般のブラウザからのアクセスしか通さないサイトでは、使いにくそうです。
Windowsでは、WSLの中で動かします。 動作環境のページはDebian 12、Ubuntu 22.04と24.04、macOS 13以降に加えて、Windows 10以降とWSLを挙げています。一方、READMEの案内では、Windows専用の実行ファイルはなく、WSLの中に入れる形です。Linuxの実行ファイルはglibcに依存するので、Alpineのようなmuslの環境では動きません。
クラウド版は別の契約です。 開発元は同じエンジンを動かすLightpanda Cloudも提供しています。ブラウザを開いていた時間で課金し、無料のプランもあります。CDPの接続は15分で切れ、エージェントとfetchはクラウドでは使えません。開くURLと取得した中身は開発元のサーバーを通るので、外に出せないデータを扱うならローカルで動かすことになります。
1.0からはfetch()とXMLHttpRequestに、CORSの制限が既定でかかるようになりました。開発元は、AIエージェントが中身を確かめていないページも開くため、CORSの検査がないと、悪意のあるページが社内のサービスを呼び出して結果を読めてしまうと説明しています。ただし、CORSの検査の合格は463件のうち371件で、まだ残りがある状態です。ほかに、--block-private-networksなどで、プライベートなアドレスやクラウドのメタデータの取得先を止める設定もあります。
置き換えやすい処理、残す処理
置き換えを試しやすいのは、JavaScriptで中身が作られるページから、テキストや値を取り出す処理です。巡回、検索のための索引作り、プリレンダリング、AIエージェントにページを読ませる処理がこれに当たります。並列の数が多いほど、メモリの差が効きます。
Chromeに残すのは、スクリーンショットや見た目の比較、座標でのクリック、CSSの表示に頼るテストです。HermesのようにLightpandaを使えるエージェントの基盤には、スクリーンショットのような未対応の操作だけをChromeに任せる作りのものもあります。
Linuxiacの記事も、Lightpandaは見た目の描画に関する検査を意図して対象から外していると書いています。自分のサイトで比べるなら、今巡回しているページをlightpanda fetch --dump markdown <URL>で取り、Chromeで取った結果と中身が同じかを見るのが早そうです。
関連する記事
AI
Anthropicの職種別プラグイン集、Claude Codeで入れると何が増えるか
Cowork向けに公開された職種別のプラグイン集knowledge-work-pluginsの123個の内訳を読み、Claude Codeで入れて、常に足されるトークンとMCPサーバーの接続の状態を確かめました。
茹で 9分
AI
REAとは:GitHubスター30万超の中身と、「2週間」の実際
AIエージェントにリバースエンジニアリングの道具を渡すMCPサーバー「REA」が、10月にGitHubのスターを急速に集めました。スターの推移とリポジトリの作成日、Ghidraなどに任せる部分、Electronアプリを静的に解析した結果、使う前の注意を整理します。
茹で 10分
ServiceNowAI
ServiceNowのAI Control Towerとは:社内のAIを見張る管制塔を基本から解説
ServiceNowのAI Control Towerは、社内のAIを1つの台帳に集め、承認、監視、停止、費用の集計までを1か所で扱う製品です(2025年5月に一般提供)。5つの柱、使う人の役割、必要なライセンス、Microsoft Agent 365との関係、公表されていない点を、空港の管制塔にたとえて解説します。
茹で 13分