可観測性とは:監視との違いと、ログ・メトリクス・トレースをつなぐID
この記事で分かること
- 可観測性はシステムの中身を知らなくても、外に出したデータから「なぜ起きているか」を問えるようにする性質で、もとは制御理論の言葉
- ログは個々の出来事、メトリクスは時間で集計した数値、トレースは1つのリクエストが通った経路を記録する。メトリクスは安いが細部が落ち、トレースは細かいが高くつく
- 3つをつなぐのはトレースIDで、HTTPではW3C Trace Contextのtraceparentヘッダーで呼び出し先に渡される
目次(9項目)
勉強会の発表では、「オブザーバビリティを入れたら原因がすぐ分かった」のように、可観測性(observability)が説明なしに使われます。11月2日にはGrafana Labsが可観測性の導入を楽にするというInstrumentation Hubの一般提供を発表しました。ただ、監視と何が違うのか、ログ・メトリクス・トレースをなぜ3つとも集めるのかは、発表の中では省かれがちです。この記事ではそこを公式のドキュメントで確かめ、3つをつなぐ仕組みを手元で動かしました。
監視との違いは問いを後から立てられるか
OpenTelemetryの入門ページの説明では、可観測性は「システムの内部の仕組みを知らなくても、そのシステムについて質問でき、外から理解できるようにするもの」です。予想していなかった問題(「unknown unknowns」)を調べられること、「なぜ起きているのか」に答えられることも挙げています。
言葉の出どころは制御理論です。CNCFのObservability Whitepaperは、「外部への出力から、システムの内部の状態をどれだけ推測できるかの尺度」という定義を引用しています。
監視(monitoring)は可観測性と重なる部分もありますが、問いを決める時期が違います。GoogleのSRE本の監視の章は、監視が答えるべき問いを「何が壊れているか」と「なぜか」の2つに分け、前者を症状、後者を原因と呼んで、HTTP 500を返しているという症状に対し、データベースが接続を拒否しているという原因を例に挙げています。アラートは症状で出し、原因は調べて突き止める、という分け方です。
大まかに分けると、監視は「何を見るか」を先に決めて、外れたら知らせる仕組みと言えそうです。可観測性は、知らせを受けたあとに、事前に決めていなかった問いを立てて原因を突き止められるか、というシステムの性質を指します。そのためには、アプリケーションが十分なデータを出していることが前提です。OpenTelemetryの入門ページは、障害を調べるために開発者が計装(データを出すコード)を足さなくて済む状態を「適切に計装されている」と呼んでいます。
ログ・メトリクス・トレースは得意な問いと費用が違う
OpenTelemetryは、システムが出すデータをシグナルと呼び、トレース、メトリクス、ログ、Baggage(シグナルのあいだで受け渡す文脈の情報)に対応しています。コードの単位で資源の使い方を記録するプロファイルは、開発中か提案の段階です。よく「3本柱」と呼ばれるのは、前の3つです。
| シグナル | 記録するもの | 得意な問い | 費用の特徴 |
|---|---|---|---|
| ログ | 時刻の付いた個々の出来事 | その時点で何が起きたか | 個々の出来事を残すので、メトリクスより処理の費用が大きい |
| メトリクス | 一定の時間で集計した数値(エラー率、CPU使用率、リクエスト数など) | 全体として正常か、いつから悪いか | 量はトラフィックでは増えず、系列の数で増える |
| トレース | 1つのリクエストが複数のサービスを通った経路 | どのサービスのどの処理で遅れたか | 詳細なぶん高くつく |
ログ
OpenTelemetryの入門ページが指摘するとおり、ログは特定のリクエストと結び付いているとは限らず、どこから呼ばれたかの文脈を持たないことが多いです。後で述べるトレースの情報と結び付けると、使い道が大きく広がります。
メトリクス
メトリクスは数値に集計したデータです。CNCFのホワイトペーパーは、メトリクスの量はトラフィックが増えても増えないので、処理の費用を予測しやすいと書いています。その代わり、集計と集計のあいだの値や、集計した単位より細かいこと(どのプロセスがメモリを使ったか、など)は分かりません。
メトリクスの費用を左右するのは、ラベルの組み合わせで生まれる系列の数(カーディナリティ)です。ホワイトペーパーの例では、データセンター100か所に各1万台のホストがあると、1つのメトリクスだけで100万の系列になります。ラベルにユーザーIDやリクエストIDのような値の種類が多いものを入れると、その種類の数だけ系列が増えます。
トレース
トレースは1つのリクエストが通った経路の記録です。経路は処理の1単位を表すスパンの集まりで、最初のスパン(ルートスパン)がリクエストの始まりから終わりまでを表し、その下に子のスパンが付きます。APIゲートウェイ、バックエンド、データベースを通るリクエストなら、それぞれがスパンになります。
多くのバックエンドは、トレースを次のような滝の図で表示します。横軸が時間で、一番上の長い棒がルートスパン、その下に字下げされた棒が子のスパンです。どの処理が全体の時間の多くを占めたかが、棒の長さで分かります。
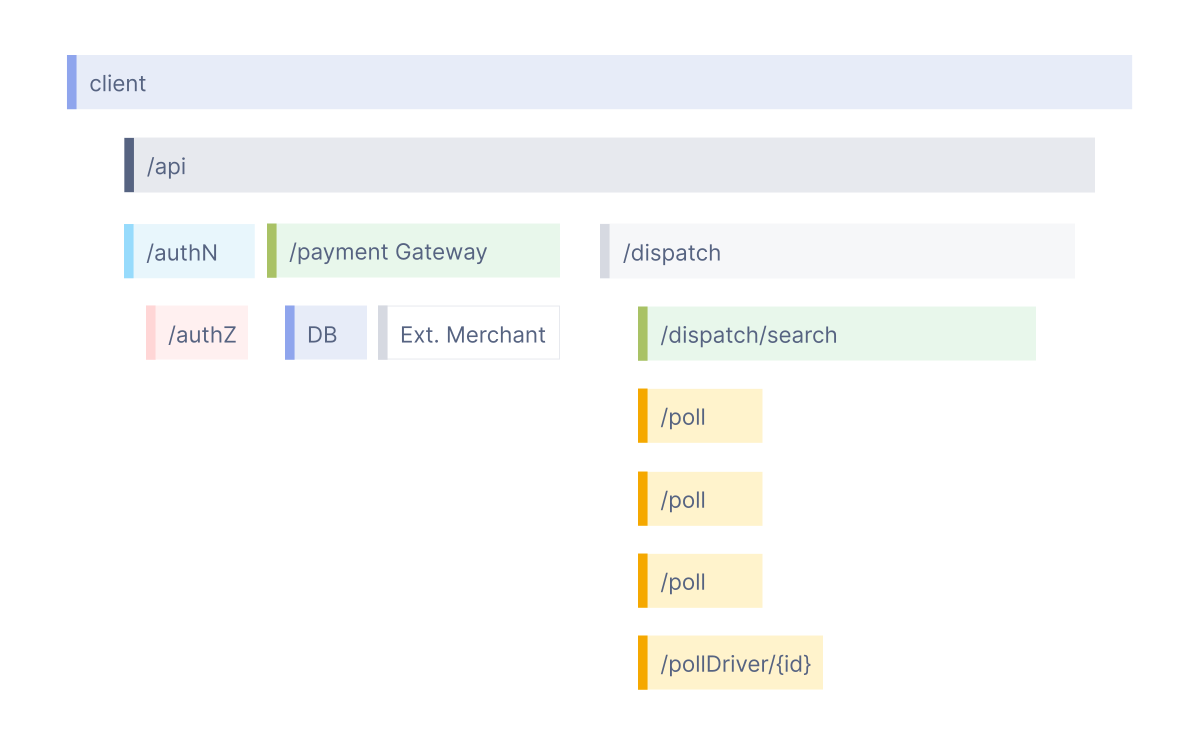
CNCFのホワイトペーパーは、トレースを詳細で高くつくシグナルとしています。全てのリクエストを記録せず一部だけを残すサンプリングを、OpenTelemetryは、見えるものを失わずに可観測性の費用を減らす最も効果的な方法の1つとしています。
何を測るかは4つのゴールデンシグナルから
全部を集めようとすると、費用も画面も増えます。SRE本は利用者に面したシステムで4つしか測れないなら、次の4つにするよう勧めています。
- レイテンシ: リクエストの処理にかかる時間。成功と失敗を分けて測る
- トラフィック: システムにかかっている需要。Webサービスなら1秒あたりのHTTPリクエスト数
- エラー: 失敗したリクエストの割合
- 飽和: CPUやメモリなど、資源がどれだけ埋まっているか
レイテンシを成功と失敗で分けるのは、データベースへの接続が切れたときのHTTP 500はすぐに返ることがあり、それを全体のレイテンシに混ぜると計算を誤りかねないからです。SRE本は遅いエラーは速いエラーよりさらに悪いとして、エラーのレイテンシも追うよう書いています。
Grafana Labsの発表にある「RED metrics」は、Tom Wilkie氏が考えたREDメソッドの指標です。1秒あたりのリクエスト数(Rate)、失敗しているリクエストの数(Errors)、リクエストにかかる時間(Duration)の3つで、ゴールデンシグナルと考え方は近そうです。
3つをつなぐのはトレースID
ダッシュボードのエラー率が上がったのに気づいても、メトリクスだけでは原因になったリクエストを特定できません。ログを検索しても、同じリクエストのログがサービスをまたいで散らばっています。そこで使うのが、同じリクエストのログとスパンに共通して付くトレースIDです。
トレースIDは1つのリクエストに振られる識別子で、呼び出し先のサービスに引き継がれます。HTTPでの引き継ぎ方は、W3CのTrace Contextがtraceparentヘッダーとして標準にしています。値は「版-トレースID-親のスパンID-フラグ」の4つを-でつないだもので、仕様の例は次のとおりです。
traceparent: 00-0af7651916cd43dd8448eb211c80319c-b7ad6b7169203331-01ログについても、OpenTelemetryのログのデータモデルにTraceIdとSpanIdの欄があります。ログにトレースIDを書いておけば、遅いトレースから、そのリクエストで出たログだけを引けます。
手元で動かして確かめる
OpenTelemetryのPython SDKで、注文の画面(GET /checkout)が在庫のサービスを呼ぶ流れを1つのプロセスの中で再現しました。呼び出し側がヘッダーに文脈を書き込み、呼び出された側がそれを取り出して子のスパンを作り、ログにトレースIDを付けます。
import logging, time
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import SimpleSpanProcessor, SpanExporter, SpanExportResult
from opentelemetry.propagate import inject, extract

class Short(SpanExporter):  # スパンを1行ずつ表示するだけの出力先
    def export(self, spans):
        for s in spans:
            c = s.context
            p = s.parent.span_id if s.parent else None
            print(f"span name={s.name} trace_id={c.trace_id:032x} span_id={c.span_id:016x} "
                  f"parent={'-' if p is None else format(p,'016x')} ms={(s.end_time-s.start_time)/1e6:.0f}")
        return SpanExportResult.SUCCESS

trace.set_tracer_provider(TracerProvider())
trace.get_tracer_provider().add_span_processor(SimpleSpanProcessor(Short()))
tracer = trace.get_tracer("demo")

class TraceIdFilter(logging.Filter):  # ログに今のトレースIDを付ける
    def filter(self, r):
        c = trace.get_current_span().get_span_context()
        r.trace_id = format(c.trace_id, "032x") if c.is_valid else "-"
        return True
logging.basicConfig(format="log level=%(levelname)s trace_id=%(trace_id)s msg=%(message)s", level=logging.INFO)
log = logging.getLogger("inventory"); log.addFilter(TraceIdFilter())

def inventory_service(headers):
    ctx = extract(headers)  # 受け取ったヘッダーから親の文脈を取り出す
    with tracer.start_as_current_span("SELECT stock", context=ctx):
        time.sleep(0.12)
        log.warning("stock query slow")

with tracer.start_as_current_span("GET /checkout"):
    headers = {}
    inject(headers)  # 呼び出し先に渡すヘッダーへ文脈を書き込む
    print("header", headers)
    inventory_service(headers)
検証した環境(Python 3.11.18、opentelemetry-sdk 1.45.2、11月3日)では、次のように出力されました。
header {'traceparent': '00-290ed4a2cd11fb6a3be0b7f189042cd8-64741dabcbd1295f-03'}
log level=WARNING trace_id=290ed4a2cd11fb6a3be0b7f189042cd8 msg=stock query slow
span name=SELECT stock trace_id=290ed4a2cd11fb6a3be0b7f189042cd8 span_id=3f104be7d80f9123 parent=64741dabcbd1295f ms=120
span name=GET /checkout trace_id=290ed4a2cd11fb6a3be0b7f189042cd8 span_id=64741dabcbd1295f parent=- ms=121
読み取れることは3つあります。
- ヘッダーの2つ目の値(
290ed4…)が、ログと2つのスパンのトレースIDと一致しています。ログからトレースへ、トレースからログへ、この値でたどれます - ヘッダーの3つ目の値は、呼び出し側のスパン(
GET /checkout)のIDで、在庫のスパンのparentに入っています。これが滝の図の親子になります - 末尾のフラグは
03でした。Trace Contextの勧告(Level 1)が定めるのは記録の対象を示す最下位のビット(01)だけです。2つ目のビットはLevel 2の草案が加えた、トレースIDを乱数で作ったことを示すビットです
ここではスパンを画面に出しただけです。実際にはOpenTelemetry Collectorなどを通してJaegerやGrafanaのようなバックエンドに送り、滝の図として表示します。
一番の手間は計装
仕組みは単純でも、全てのサービスにこの計装を入れるのは大変です。Grafana Labsの発表も、システムの意味のある範囲を計装し終えるまでに「数か月の手作業」がかかることがあり、計装が可観測性を始めるときの最大のボトルネックだと書いています。
Instrumentation Hubでは、KubernetesのクラスターにHelmのコマンド1つでAlloy(GrafanaのOpenTelemetry Collectorの配布版)を入れます。するとクラスターで動いているものが名前空間と技術ごとに一覧になり、どれが計装済みかが分かる仕組みです。そこから選んだサービスに、OpenTelemetryの自動計装のSDKを、Podを再起動せずに入れられるとしています。対象はGrafana CloudのスタックにつないだLinuxのKubernetesクラスターです。
発表は導入の順番も示しています。まずインフラ(コードが動くマシン)を見えるようにし、次にREDメトリクスとサービスどうしの関係でシステム全体を見渡し、そのあとで分散トレースに進む、という順です。
小さく始めるなら、ゴールデンシグナルの4つをメトリクスで取り、ログにトレースIDを付けるところからでもよさそうです。トレースを全サービスに入れるのはその後でも、ログに付けたトレースIDで、症状から原因のリクエストまでたどれます。
検証環境
- 最終検証日
- 試した環境
- Python 3.11.18
- opentelemetry-sdk 1.45.2
関連する記事
AI
Google Cloud経由のClaude Code、組織での費用の上限と効果の測り方
Google CloudのAgent Platform経由でClaude Codeを使う組織向けに、予算と上限のかけ方、利用状況の集め方、効果の指標を、Anthropicが10月27日に公開した解説記事と公式ドキュメントで確かめます。
茹で 13分
インフラ
取手市の「脱VDI」:物理PCの集約で、更改費と運用はどう変わったか
茨城県取手市は、VDIのままでは情報系サーバー全体の更改が前回の4倍以上になると分かり、VDIをやめてLGWAN接続系の350台を物理PCカートリッジを集めた「リモートPCアレイ」に移しました。費用と運用がどう変わったか、物理に戻すと何を引き受けるのかを、事例と製品の資料から確かめます。
茹で 9分