ServiceNow Impactの10月更新:Platform Healthのスコアの読み替え方
この記事で分かること
- ImpactのStoreアプリv12(2026年10月8日)で、Platform Healthのスコアが重み付けの方式に変わった。次のFullかDeltaのスキャンから新しい方式で計算され、過去のスコアは再計算されない
- 評価の帯は4段階から3段階になり、新しい方式では40点以上が「Good」。旧方式の数字と並べて比べない
- 計算式と定義の数は、コミュニティの記事とDocsで書き方が違う。社内で説明するときは、どの資料に基づくかを決めておく
- 設定はSetup Hubの1か所にまとまり、成熟度評価は複数人で回答してExcelの行動計画まで作れるようになった
目次(10項目)
ServiceNow Impactは、ServiceNowが有償で提供するカスタマーサクセスの製品です。インスタンスに入れる「Impactアプリ」(Storeアプリ)から、製品の導入計画、価値の測定、Platform Healthによるインスタンスの健全性の診断を行えます。
2026年10月8日に、このアプリのv12が公開されました。ServiceNowのコミュニティに載ったQ4のリリースの告知は、Setup Hub、新しいスコア、検査の定義の拡大、人事と顧客サービスの価値のモデル、成熟度評価の5つを挙げています。Platform Healthのスコアをインスタンスの状態として上司や顧客に報告している管理者にとって、一番影響が大きいのはスコアの見直しです。次にスキャンを実行した時点で、インスタンスに何も変更を加えていなくても、数字が上がるか下がるためです。
新機能はImpactアプリだけで使える
Q4の告知は、今回の機能はImpactアプリ限定だと書いています。ServiceNow Storeでは、Impactアプリの価格は「Paid」と表示されています。
Impactの契約は、公式ドキュメントによると、Guided、Total、Integrated Successの3つのパッケージに分かれます。入門の位置づけのGuidedには担当のカスタマーサクセスマネージャーが付き、Totalにはカスタマーサクセスの責任者やプラットフォームのアーキテクトを含むチームが付きます。料金は公開されていません。ServiceNowの契約交渉を支援するUpperEdgeは、2025年12月の記事で、定価はGuidedが年間のサブスクリプション料金の10%、Totalが30%だとしています。これは第三者の見方で、ServiceNowの公式の数字ではありません。
Platform Healthの診断機能の元は、ServiceNowが2025年に買収したBravium Labsのアプリ(Best Practice Engine)です。買収の後の説明によると、スキャンの機能は、有償のImpactであればどのプランにも含まれます。Guidedでは自分で作る検査の定義(カスタム定義)のうち、有効にできるのは10個までで、修正案のライブラリ(Proposed Fix)は使えません。Totalと同じ機能にするには、Platform Healthのアドオンを買います。
Platform Healthのスコアは何が変わるのか
Platform Healthは、ServiceNowのベストプラクティスに沿った検査の定義でインスタンスをスキャンする機能です。見つかった問題(Finding)は、0から100のスコアにまとめられます。ServiceNowの社員がコミュニティに書いたスコアの解説は、旧方式の問題を3つ挙げています。全てのFindingを同じ重さで数えるため重大な問題が目立たないこと、新しい定義が追加されるだけでスコアが動くこと、全体を調べるFull Scanと差分だけを調べるDelta Scanで対象の範囲が違い、結果がずれることです。
新しい方式では定義ごとに重大度、カテゴリ、影響度で重みを付けます。セキュリティの重大な問題を直したときのほうが、UXの細かい問題を直したときより、スコアが大きく動く仕組みです。解説の記事は、定義が10個だけの例を示しています。21点から始めて、セキュリティのFindingを6件直すと41点上がり、UXのFindingを190件直しても2点しか上がりません。記事はこれは例示で、実際の結果は環境によって違うと断っています。
ServiceNow Docsは、カテゴリごとに0から100で採点してから、次の重みで合算すると説明しています。重みは表の見出しが「Proposed weight」(案)で、どれも「約」の値です。
| カテゴリ | 重み |
|---|---|
| セキュリティ | 約40% |
| パフォーマンス | 約22% |
| 管理のしやすさ(Manageability) | 約19% |
| アップグレードのしやすさ(Upgradeability) | 約9% |
| ユーザー体験 | 約9% |
あるカテゴリのFindingを直しても、ほかのカテゴリのスコアは動きません。
評価の帯が変わる
スコアの区切りも変わりました。旧方式と新方式の帯は次のとおりです。
| 方式 | 帯 |
|---|---|
| 旧方式 | At Risk(0〜70)、Fair(70〜80)、Good(80〜90)、Excellent(90〜100) |
| 新方式 | At risk(0〜19)、Needs attention(20〜39)、Good(40〜100) |
旧方式では70点未満が「At Risk」でしたが、新方式では40点以上が「Good」です。同じ60点でも旧方式ならAt Risk、新方式ならGoodです。解説の記事も、計算の方法が違う2つの方式のスコアは、同じ方式の中で比べるよう求めています。社内の報告書で月ごとの推移を折れ線にしているなら、切り替えの月に注記を入れ、旧方式の数字とつながないようにする必要があります。
いつから、誰に適用されるか
新しい方式はImpactアプリv12で新しくFull ScanかDelta Scanを実行したときに適用されます。過去のスキャンのスコアは再計算されず、そのまま残ります。対象はImpactアプリのPlatform Healthの画面を使っている利用者で、Health Assessmentのレポートは、これまでの採点方式のままです。この2つのスコアも比べないように、と解説の記事は書いています。
最初のスコアは、上がることも下がることもあります。解説の記事は、インスタンスの健全性が急に変わったのではなく、新しい基準での出発点になると説明しています。勧めている手順は次の4つです。
- 解説の記事に添付されたガイドとFAQを読み、Application ManagerでImpactアプリv12を確かめる
- Full Scanを実行し、スコアと帯を記録して基準にする
- 重大度が最も高いAct(対応が必要)のレベルのセキュリティのFindingから直す
- 新しいスコアで進み具合を報告する
資料によって書き方が違う点
今回の変更を説明する資料は、コミュニティの記事が2本、Docs、Storeのリリースノートと分かれており、いくつかの点で食い違いがあります。
1つ目は検査の定義の数です。Q4の告知は、スキャンの定義の移行が終わり、定義が544個から1,004個に増えたと書いています。スコアの解説は旧方式の300個余りから1,000個余りに増えたと書いています。比べている対象が違う可能性がありますが、資料からは確かめられませんでした。
2つ目は計算式です。スコアの解説に載っている式は、検出された定義の重みの合計を、全定義の重みから計算した上限で割り、その割合を100点から差し引く形です。検出の広がりは最も多かった件数と比べて測っています。Docsの式は定義ごとに作成時に決めた固定の基準と比べ、カテゴリごとに採点してから重みでまとめる形です。Storeのリリースノートは、Docsと同じく、5つのカテゴリを個別に評価して固定の基準と比べる方式を説明しています。スコアの解説に添付されたFAQも、「100 ×(1 − 検出されたリスク ÷ 最大のリスク)」という、解説と同じ形の式を載せています。一方でDocsは最も多かった件数と比べるのは以前の方式だと書いています。コミュニティの2つの資料とDocsのどちらが今の実装に合っているかは、資料からは決められません。
3つ目は対応するリリースです。スコアの解説はBrazil Patch 1、Australia Patch 7、Zurich Patch 13と互換性があると書いています。Storeのv12のページは、Brazil、Australia Patch 5、Zurich Patch 12を挙げています。インスタンスに入れられるかは、Storeでインスタンスのバージョンを選んで確かめるのが確実です。
社内でスコアを説明するときは、どの資料の計算方式に基づくかを報告書に書いておくと、後で問い合わせが来ても根拠を示せます。
Setup Hubで設定を1か所にまとめた
これまでの設定(Guided Setup)は、順番に進む文字の多い画面でした。v12ではImpact Setup Hubに置き換わりました。Q4の告知によると、アプリのインストールから設定の完了までを1か所で進められ、ServiceNow OttoのAIが手順を補助します。設定の進み具合はアップグレードしても失われません。
Setup Hubを使うには、impact app adminとadminのロールが必要です。ServiceNowのランディングページで「Manage Your Products」から「Impact」を選ぶと、インストールされていなければインストールから始まります。設定の項目は6つに分かれています。AIエージェント、利用者とアクセス、Platform Health、インスタンスの登録、データの同期と移行、価値の測定に使うデータの収集です。Platform Healthの設定だけで7つの手順があります。いくつかの項目は順番が決まっており、前の項目を終えないと次に進めません。途中でやめても後から続きを進められます。
人事と顧客サービスの価値のモデルが新しくなった
Q4の告知によると、人事と顧客サービスの価値のモデルとダッシュボードが、8月のITSMと同じ形に更新されました。対象はHR Service DeliveryとCustomer Service Managementです。お金に換算できる成果と換算できない成果を並べて表示し、計算式と前提を見直して調整できます。今のモデルは、利用者が切り替えるまでそのまま残ります。
Docsのリリースノートによると、推定値で計算していた指標を、Performance Analyticsの実データに切り替える設定も追加されました。投資対効果を金額で示すValue Reportsは、製品ごとに2年分以上のデータがないと作れません。また、Impactアプリでは、Impact Delivery Instanceで公開されたレポートを見られるだけで、レポートの作成や管理はできません。導入して間もない製品では、ダッシュボードに数字が出ていても、レポートはまだ作れない段階です。
成熟度評価を複数人で回答できるようになった
ImpactにはAcceleratorと呼ばれる、範囲を決めた支援のメニューがあります。その中の成熟度評価(Maturity Assessment)は、これまで1人で回答する形でした。v12では、評価の担当者がほかのメンバーを招き、領域ごとに質問を割り当てて回答してもらえます。Docsによると、回答の収集期間は14日間です。質問は全て単一選択で、計画や文書ではなく今の実際の運用に当てはまるものを選びます。質問と領域の重みは全て同じです。
担当者は全員の回答をまとめた結果を見られますが、参加者どうしはお互いの回答を見られません。領域ごとに目標の水準を決めると、差の大きい質問が示され、担当者と備考を付けた行動計画が作られます。Storeのリリースノートによると、行動計画は、概要のシートと領域ごとのシートを持つExcelのファイルとして出力できます。
Impactの契約には、Acceleratorを同時に使える数の上限があります。Guidedは全ての種類を合わせて同時に1つまでです。複数人で回答を集める14日間が、この上限の中でどう数えられるかは、資料には書かれていませんでした。
そのほかの変更
Docsのリリースノートには、Platform Healthの定義を必要なときに実行するスキャンが、インスタンスあたり平均1分未満で終わるようになったとも書かれています。9月のv11では、必要なときにAPIでスキャンを実行できるScan Engine APIが追加されており、CI/CDの承認の段階にFindingの結果を組み込めます。
分からないこと
Impactアプリの画面が日本語に対応しているかは、Storeのページにも、Docsにも書かれていませんでした(Docs自体には日本語版があります)。日本で契約できるパッケージは、ServiceNowの日本向けの契約条件のページに載っているようですが、このページは取得できず、確かめられませんでした。また、計算式について2つの資料のどちらが今の実装に合っているかは、公開された資料からは判断できません。
関連する記事
ServiceNow
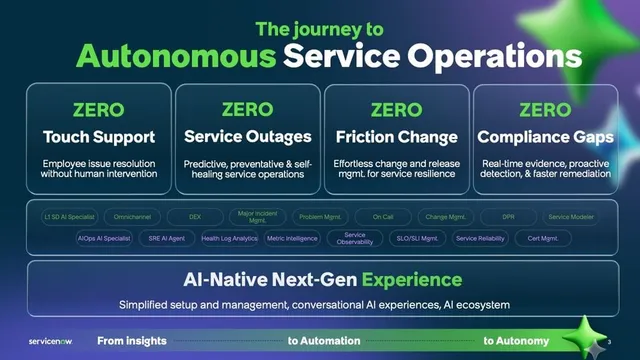
ServiceNowの「Four Zeros」とは:自律的なIT運用の導入ブループリント
ServiceNowが2026年10月19日にコミュニティで公開した「Four Zeros」は、製品ではなく、ITSM・ITOM・CMDBを組み合わせて使う順番を示した導入の資料です。4つの目標の中身、6段階と関門の進め方、Admin CenterのAdoption Blueprintsとの違い、まだ分からないことを整理します。
茹で 14分
ServiceNowAI
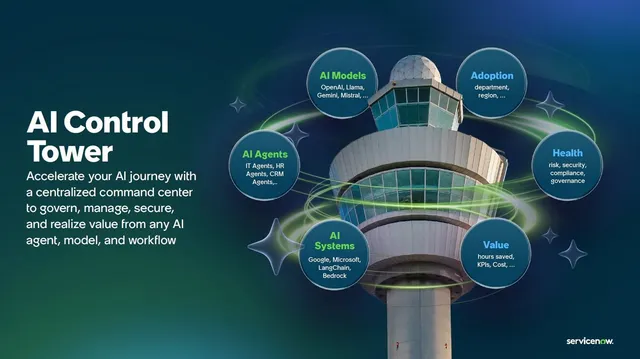
ServiceNowのAI Control Towerとは:社内のAIを見張る管制塔を基本から解説
ServiceNowのAI Control Towerは、社内のAIを1つの台帳に集め、承認、監視、停止、費用の集計までを1か所で扱う製品です(2025年5月に一般提供)。5つの柱、使う人の役割、必要なライセンス、Microsoft Agent 365との関係、公表されていない点を、空港の管制塔にたとえて解説します。
茹で 13分
ServiceNowセキュリティ
ServiceNowが買収したArmisとは:工場や病院の機器まで見つける仕組み
ServiceNowが2026年4月に約77.5億ドルで買収を完了したArmisを解説します。エージェントを入れずに工場や病院の機器まで見つける仕組み、ServiceNowが買った理由、Vezaと組み合わせたAutonomous Securityの6つの製品群と提供時期、公表されていない点を順に見ます。
茹で 14分